
과거 데이터에서 가장 좋아 보이는 변수를 찾은 뒤 남겨둔 구간에서 한 번 검증하면 과최적화 문제는 끝난 것처럼 보입니다. 하지만 한 번의 성공은 특정 시장 환경이 잘 맞았던 결과일 수 있습니다.
실제 운용에서는 시간이 흐를수록 새로운 데이터가 쌓입니다. 같은 변수를 계속 쓸지, 최근 데이터를 포함해 다시 선택할지 결정해야 합니다. 이 과정을 과거 여러 시점에서 반복하는 방법이 전진분석입니다.
이번에는 EMA 교차 전략의 49개 변수 조합을 매년 다시 평가했습니다. 2018년부터 2025년까지 여덟 번, 각 연도가 시작되기 전에 사용할 변수를 정하고 해당 연도의 표본외 성과만 연결했습니다.
과거 데이터를 계속 누적하는 확장형은 +301.42%, 최근 4년만 사용하는 롤링형은 +305.26%였습니다. 수익률과 MDD는 거의 같았지만 확장형은 변수를 4번, 롤링형은 5번 바꿨습니다. 최근 데이터에 더 민감한 방식이 변수를 더 자주 바꿨지만 성과 차이는 크지 않았습니다.
SYSTEM LAB 12 핵심 결과
- 국내 주식 30종목, EMA 변수 49개, 8개 연간 표본외 구간 검증
- 확장형: 누적수익률 +301.42%, CAGR +18.99%, MDD -22.92%
- 롤링형: 누적수익률 +305.26%, CAGR +19.14%, MDD -23.06%
- 두 방식 모두 8년 중 7년 수익, 2022년에는 -16.87%
- 확장형 변수 변경 4회·고유 조합 4개, 롤링형 변경 5회·고유 조합 5개
- 고정 EMA 20·100: +287.41%, MDD -22.68%
1. 전진분석은 시간을 되돌려 운용 절차를 반복한다
일반적인 백테스트는 전체 기간에 하나의 규칙을 적용합니다. 전진분석은 시점을 여러 개로 나누고 각 시점에서 당시 알 수 있었던 데이터만 사용합니다.
한 단계는 다음 순서로 진행됩니다.
- 과거 구간에서 여러 변수 조합을 평가합니다.
- 정해둔 기준으로 사용할 변수를 하나 선택합니다.
- 선택에 쓰지 않은 다음 구간에 그 변수를 적용합니다.
- 다음 시점으로 이동해 같은 과정을 반복합니다.
- 각 단계의 표본외 성과만 이어 붙입니다.
2020년 성과를 계산할 때 2021년 이후 데이터가 변수 선택에 들어가면 안 됩니다. 미래 데이터를 한 번이라도 선택 기준에 넣으면 전진분석의 의미가 사라집니다.
최고 수익률과 평탄 구간을 비교한 EMA 변수 실험에서는 선택 구간과 한 번의 검증 구간을 나눴습니다. 이번에는 그 분할을 한 해씩 앞으로 이동합니다.
2. 확장형과 롤링형의 차이
두 방식은 검증 연도는 같지만 변수를 고르는 과거 구간이 다릅니다.
확장형 전진분석
확장형은 시작점을 2014년으로 고정하고 학습 구간을 계속 늘립니다.
2014~2017 선택 → 2018 검증
2014~2018 선택 → 2019 검증
2014~2019 선택 → 2020 검증
오래된 시장과 최근 시장을 모두 포함하므로 변수 변화가 상대적으로 완만할 수 있습니다. 반면 오래된 데이터의 영향이 계속 남습니다.
롤링형 전진분석
롤링형은 최근 4년만 남기고 시작점과 종료점을 함께 이동합니다.
2014~2017 선택 → 2018 검증
2015~2018 선택 → 2019 검증
2016~2019 선택 → 2020 검증
최근 시장 구조를 빠르게 반영하지만 짧은 구간의 우연한 움직임에 더 민감할 수 있습니다. 과거를 많이 쓰는 것이 항상 좋거나 최근 데이터만 쓰는 것이 항상 유리한 것은 아닙니다.
3. 매년 최고점 대신 주변이 고른 조합을 선택한다
전진분석 안에서 매년 누적수익률 1위만 고르면 과최적화를 여러 번 반복할 수 있습니다. 그래서 LAB 11에서 사용한 평탄 구간 기준을 이어갑니다.
빠른 EMA 7개와 느린 EMA 7개를 조합해 49개 후보를 만듭니다. 각 조합 주변의 3×3 영역에서 CAGR 중앙값을 구하고 표준편차를 뺍니다.
평탄 점수 = 주변 9개 CAGR 중앙값 - 주변 9개 CAGR 표준편차
평탄 점수가 가장 높은 조합을 다음 한 해에 적용합니다. 선택 기준은 모든 단계에서 고정하며 검증 연도의 수익률을 본 뒤 후보를 바꾸지 않습니다.
4. 실험 규칙
| 항목 | 이번 검증의 고정 규칙 |
|---|---|
| 입력 데이터 | yfinance 수정주가 일봉 시가·종가 |
| 종목 | 국내 대형·유동성 종목 30개 고정 목록 |
| 최초 선택 구간 | 2014~2017년 |
| 표본외 검증 | 2018~2025년, 1년씩 8회 |
| 확장형 | 2014년 시작점을 고정하고 매년 종료 시점 확장 |
| 롤링형 | 직전 4년만 사용하고 매년 한 해씩 이동 |
| 빠른 EMA | 10, 15, 20, 25, 30, 35, 40일 |
| 느린 EMA | 60, 80, 100, 120, 140, 160, 180일 |
| 진입·청산 | 빠른 EMA의 느린 EMA 상향·하향 교차 |
| 체결 | 종가 신호 확정 후 다음 거래일 시가 |
| 비용 | 매수·매도 각각 0.05% |
| 포트폴리오 | 종목별 초기 자산을 동일 비중으로 평균 |
| 연도 전환 | 연말 종가로 청산 후 새 변수로 다음 단계 시작 |
각 검증 연도는 현금 상태에서 시작합니다. 직전 거래일 종가 기준으로 새 조합이 상승 상태라면 검증 연도의 첫 거래일 시가에 진입할 수 있습니다. 연말에는 다음 변수 선택을 위해 보유 포지션을 종가로 정리하고 매도 비용을 적용했습니다.
이 방식은 실제 계좌의 연속 보유와 다르지만 변수 교체 시점을 명확하게 만들고 두 분석 방법을 같은 조건으로 비교할 수 있습니다.
5. 전체 Python 코드
필요한 패키지는 터미널에서 먼저 설치합니다.
python -m pip install yfinance pandas numpy matplotlib pyarrow
아래 코드 하나가 가격 수집, 49개 변수 평가, 평탄 구간 선택, 8단계 전진분석, 고정 EMA 비교와 차트 생성을 모두 수행합니다.
#!/usr/bin/env python3
"""EMA 변수 선택을 확장형과 롤링형 전진분석으로 반복해 표본외 성과를 비교한다."""

from __future__ import annotations

import time
from pathlib import Path

import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import yfinance as yf
from matplotlib import font_manager

TICKERS = ["005930.KS", "000660.KS", "005380.KS", "000270.KS", "035420.KS", "035720.KS", "068270.KS", "207940.KS", "105560.KS", "055550.KS", "066570.KS", "012330.KS", "028260.KS", "017670.KS", "009150.KS", "003670.KS", "042700.KS", "000810.KS", "196170.KQ", "247540.KQ", "086520.KQ", "058470.KQ", "035900.KQ", "041510.KQ", "067160.KQ", "263750.KQ", "293490.KQ", "112040.KQ", "036930.KQ", "240810.KQ"]
FAST_WINDOWS = [10, 15, 20, 25, 30, 35, 40]
SLOW_WINDOWS = [60, 80, 100, 120, 140, 160, 180]
TEST_YEARS = list(range(2018, 2026))
DOWNLOAD_START = "2012-01-01"
DOWNLOAD_END = "2026-01-01"
INITIAL_TRAIN_START = "2014-01-01"
ROLLING_YEARS = 4
COST_RATE = 0.0005
MIN_ROWS = 252
MIN_PERIOD_ROWS = 200
PRICE_CACHE_FILE = Path("walk_forward_prices.parquet")
CHART_FILE = Path("walk_forward_chart.png")
STEP_FILE = Path("walk_forward_steps.csv")
SUMMARY_FILE = Path("walk_forward_summary.csv")

def read_price_cache(path: Path) -> dict[str, pd.DataFrame]:
    cached = pd.read_parquet(path)
    cached["date"] = pd.to_datetime(cached["date"])
    return {ticker: group.set_index("date")[["open", "high", "low", "close", "volume"]].sort_index() for ticker, group in cached.groupby("ticker")}

def download_prices() -> dict[str, pd.DataFrame]:
    if PRICE_CACHE_FILE.is_file():
        return read_price_cache(PRICE_CACHE_FILE)

    raw = yf.download(TICKERS, start=DOWNLOAD_START, end=DOWNLOAD_END, auto_adjust=True, progress=False, group_by="ticker", threads=False)
    if raw.empty:
        raise RuntimeError("가격 데이터를 받지 못했습니다.")
    prices = {}
    for ticker in TICKERS:
        frame = raw[ticker].rename(columns=str.lower).dropna(subset=["open", "high", "low", "close"]).copy()
        if len(frame.loc[frame.index < DOWNLOAD_END]) < MIN_ROWS:
            for attempt in range(3):
                retry = yf.download(ticker, start=DOWNLOAD_START, end=DOWNLOAD_END, auto_adjust=True, progress=False, threads=False)
                if isinstance(retry.columns, pd.MultiIndex):
                    retry.columns = retry.columns.get_level_values(0)
                candidate = retry.rename(columns=str.lower).dropna(subset=["open", "high", "low", "close"]).copy()
                if len(candidate) > len(frame):
                    frame = candidate
                if len(frame.loc[frame.index < DOWNLOAD_END]) >= MIN_ROWS:
                    break
                time.sleep(1.0 + attempt)
        if len(frame.loc[frame.index < DOWNLOAD_END]) < MIN_ROWS:
            raise RuntimeError(f"검증에 필요한 가격 데이터가 부족합니다: {ticker}")
        prices[ticker] = frame
    PRICE_CACHE_FILE.parent.mkdir(parents=True, exist_ok=True)
    cached = pd.concat([frame.reset_index(names="date").assign(ticker=ticker) for ticker, frame in prices.items()], ignore_index=True)
    cached.to_parquet(PRICE_CACHE_FILE, index=False)
    return prices

def prepare_prices(prices: dict[str, pd.DataFrame]) -> dict[str, pd.DataFrame]:
    prepared = {}
    for ticker, raw in prices.items():
        data = raw.copy()
        for window in sorted(set(FAST_WINDOWS + SLOW_WINDOWS)):
            data[f"ema_{window}"] = data["close"].ewm(span=window, adjust=False, min_periods=window).mean()
        prepared[ticker] = data
    return prepared

def build_strategy_matrices(prepared: dict[str, pd.DataFrame], fast_window: int, slow_window: int, calendar: pd.DatetimeIndex) -> tuple[pd.DataFrame, pd.DataFrame, pd.DataFrame]:
    factor_columns = []
    position_columns = []
    entry_factor_columns = []
    for ticker, data in prepared.items():
        regime = data[f"ema_{fast_window}"] > data[f"ema_{slow_window}"]
        position_open = regime.shift(1, fill_value=False)
        previous_position = position_open.shift(1, fill_value=False)
        entry_day = position_open & ~previous_position
        holding_day = position_open & previous_position
        exit_day = ~position_open & previous_position
        previous_close = data["close"].shift(1)
        factor = pd.Series(1.0, index=data.index)
        factor.loc[entry_day] = data.loc[entry_day, "close"] / data.loc[entry_day, "open"] * (1.0 - COST_RATE)
        factor.loc[holding_day] = data.loc[holding_day, "close"] / previous_close.loc[holding_day]
        factor.loc[exit_day] = data.loc[exit_day, "open"] / previous_close.loc[exit_day] * (1.0 - COST_RATE)
        entry_factor = data["close"] / data["open"] * (1.0 - COST_RATE)
        factor_columns.append(factor.reindex(calendar).fillna(1.0).rename(ticker))
        position_columns.append(position_open.reindex(calendar).fillna(False).rename(ticker))
        entry_factor_columns.append(entry_factor.reindex(calendar).fillna(1.0).rename(ticker))
    return pd.concat(factor_columns, axis=1), pd.concat(position_columns, axis=1).astype(bool), pd.concat(entry_factor_columns, axis=1)

def evaluate_period(factors: pd.DataFrame, positions: pd.DataFrame, entry_factors: pd.DataFrame, start: str, end: str, include_equity: bool = False) -> tuple[dict[str, float], pd.DataFrame | None]:
    mask = (factors.index >= start) & (factors.index < end)
    sample_factors = factors.loc[mask].copy()
    sample_positions = positions.loc[mask].copy()
    sample_entry_factors = entry_factors.loc[mask]
    if len(sample_factors) < MIN_PERIOD_ROWS:
        raise RuntimeError(f"검증 구간 데이터가 부족합니다: {start}~{end}")

    first_position = sample_positions.iloc[0]
    sample_factors.iloc[0] = np.where(first_position, sample_entry_factors.iloc[0], 1.0)
    last_position = sample_positions.iloc[-1]
    sample_factors.iloc[-1] *= np.where(last_position, 1.0 - COST_RATE, 1.0)
    ticker_equity = sample_factors.cumprod()
    equity = ticker_equity.mean(axis=1)
    drawdown = equity / equity.cummax() - 1.0
    elapsed_years = max((equity.index[-1] - equity.index[0]).days / 365.25, 1.0 / 365.25)
    entries = sample_positions.astype(int).diff().eq(1).sum().sum() + int(first_position.sum())
    summary = {"return": float(equity.iloc[-1] - 1.0), "cagr": float(equity.iloc[-1] ** (1.0 / elapsed_years) - 1.0), "mdd": float(drawdown.min()), "trade_count": int(entries), "exposure": float(sample_positions.mean(axis=1).mean())}
    daily = pd.DataFrame({"equity": equity, "drawdown": drawdown}) if include_equity else None
    return summary, daily

def select_plateau(grid: pd.DataFrame) -> tuple[int, int, float, float, float]:
    matrix = grid.pivot(index="fast_window", columns="slow_window", values="train_cagr").reindex(index=FAST_WINDOWS, columns=SLOW_WINDOWS)
    candidates = []
    for fast_index in range(1, len(FAST_WINDOWS) - 1):
        for slow_index in range(1, len(SLOW_WINDOWS) - 1):
            neighborhood = matrix.iloc[fast_index - 1:fast_index + 2, slow_index - 1:slow_index + 2].to_numpy().ravel()
            median_cagr = float(np.nanmedian(neighborhood))
            standard_deviation = float(np.nanstd(neighborhood))
            candidates.append({"fast_window": FAST_WINDOWS[fast_index], "slow_window": SLOW_WINDOWS[slow_index], "neighbor_median_cagr": median_cagr, "neighbor_std_cagr": standard_deviation, "plateau_score": median_cagr - standard_deviation})
    selected = pd.DataFrame(candidates).sort_values(["plateau_score", "neighbor_median_cagr"], ascending=False).iloc[0]
    return int(selected["fast_window"]), int(selected["slow_window"]), float(selected["neighbor_median_cagr"]), float(selected["neighbor_std_cagr"]), float(selected["plateau_score"])

def chain_segments(segments: list[pd.DataFrame]) -> pd.DataFrame:
    chained = []
    capital = 1.0
    for segment in segments:
        part = segment.copy()
        part["equity"] *= capital
        capital = float(part["equity"].iloc[-1])
        chained.append(part[["equity"]])
    result = pd.concat(chained)
    result["drawdown"] = result["equity"] / result["equity"].cummax() - 1.0
    return result

def summarize_method(method: str, steps: pd.DataFrame, equity: pd.DataFrame) -> dict[str, float | int | str]:
    elapsed_years = (equity.index[-1] - equity.index[0]).days / 365.25
    parameter_pairs = list(zip(steps["fast_window"], steps["slow_window"]))
    changes = sum(left != right for left, right in zip(parameter_pairs, parameter_pairs[1:]))
    efficiency = steps["test_return"] / steps["train_cagr"].replace(0.0, np.nan)
    return {"method": method, "return": float(equity["equity"].iloc[-1] - 1.0), "cagr": float(equity["equity"].iloc[-1] ** (1.0 / elapsed_years) - 1.0), "mdd": float(equity["drawdown"].min()), "positive_years": int((steps["test_return"] > 0.0).sum()), "parameter_changes": int(changes), "unique_parameters": int(len(set(parameter_pairs))), "median_forward_efficiency": float(efficiency.median()), "average_trades": float(steps["test_trade_count"].mean()), "average_exposure": float(steps["test_exposure"].mean())}

def configure_font() -> None:
    available_fonts = {item.name for item in font_manager.fontManager.ttflist}
    for font_name in ("Malgun Gothic", "AppleGothic", "UnDotum", "DejaVu Sans"):
        if font_name in available_fonts:
            plt.rcParams["font.family"] = font_name
            break
    plt.rcParams["axes.unicode_minus"] = False

def draw_chart(steps: pd.DataFrame, equities: dict[str, pd.DataFrame], summary: pd.DataFrame) -> None:
    colors = {"확장형": "#0F766E", "롤링형": "#F59E0B", "고정 EMA 20·100": "#64748B"}
    fig = plt.figure(figsize=(14, 10), facecolor="white")
    grid = fig.add_gridspec(2, 2, height_ratios=[1.35, 1.0], hspace=0.34, wspace=0.24)
    equity_axis = fig.add_subplot(grid[0, :])
    return_axis = fig.add_subplot(grid[1, 0])
    parameter_axis = fig.add_subplot(grid[1, 1])

    for method, equity in equities.items():
        label_row = summary.loc[summary["method"] == method].iloc[0]
        equity_axis.plot(equity.index, equity["equity"], color=colors[method], linewidth=2.5 if method != "고정 EMA 20·100" else 1.8, label=f"{method} {label_row['return']:+.1%} · MDD {label_row['mdd']:.1%}")
    equity_axis.axhline(1.0, color="#9CA3AF", linewidth=1.0)
    equity_axis.set_title("한 해씩 변수를 다시 고른 뒤 표본외 성과만 연결했다", fontsize=18, fontweight="bold", pad=16)
    equity_axis.set_ylabel("동일 비중 누적 자산")
    equity_axis.legend(loc="upper left", frameon=False, ncol=3)

    x = np.arange(len(TEST_YEARS))
    width = 0.36
    for offset, method in ((-width / 2, "확장형"), (width / 2, "롤링형")):
        values = steps.loc[steps["method"] == method].set_index("test_year").reindex(TEST_YEARS)["test_return"] * 100.0
        return_axis.bar(x + offset, values, width, color=colors[method], label=method)
    return_axis.axhline(0.0, color="#9CA3AF", linewidth=1.0)
    return_axis.set_xticks(x, [str(year)[2:] for year in TEST_YEARS])
    return_axis.set_xlabel("검증 연도")
    return_axis.set_ylabel("표본외 수익률(%)")
    return_axis.set_title("연도별 표본외 성과", fontsize=14, fontweight="bold")
    return_axis.legend(frameon=False)

    parameter_axis.set_xlim(-0.6, len(TEST_YEARS) - 0.4)
    parameter_axis.set_ylim(-0.6, 1.6)
    parameter_axis.set_xticks(x, [str(year)[2:] for year in TEST_YEARS])
    parameter_axis.set_yticks([0, 1], ["롤링형", "확장형"])
    parameter_axis.set_xlabel("검증 연도")
    parameter_axis.set_title("매년 다시 선택된 EMA 기간", fontsize=14, fontweight="bold")
    for row, method in enumerate(("롤링형", "확장형")):
        method_steps = steps.loc[steps["method"] == method].set_index("test_year").reindex(TEST_YEARS)
        for column, (_, selected) in enumerate(method_steps.iterrows()):
            rectangle = plt.Rectangle((column - 0.45, row - 0.35), 0.9, 0.7, facecolor=colors[method], alpha=0.16, edgecolor=colors[method], linewidth=1.4)
            parameter_axis.add_patch(rectangle)
            parameter_axis.text(column, row, f"{int(selected['fast_window'])}/{int(selected['slow_window'])}", ha="center", va="center", color="#14213D", fontsize=9, fontweight="bold")
    parameter_axis.grid(False)

    for axis in (equity_axis, return_axis, parameter_axis):
        axis.grid(axis="y", color="#E5E7EB", linewidth=0.8)
        axis.spines["top"].set_visible(False)
        axis.spines["right"].set_visible(False)
    fig.suptitle("확장형과 롤링형 전진분석은 같은 전략에서도 다른 변수 경로를 만든다", fontsize=21, fontweight="bold", y=0.99)
    CHART_FILE.parent.mkdir(parents=True, exist_ok=True)
    fig.savefig(CHART_FILE, dpi=160, bbox_inches="tight", facecolor="white")
    plt.close(fig)

configure_font()
prices = download_prices()
prepared = prepare_prices(prices)
calendar = pd.DatetimeIndex(sorted(set().union(*(data.loc[(data.index >= INITIAL_TRAIN_START) & (data.index < DOWNLOAD_END)].index for data in prepared.values()))))
periods = set()
for test_year in TEST_YEARS:
    test_start = f"{test_year}-01-01"
    test_end = f"{test_year + 1}-01-01"
    periods.add((INITIAL_TRAIN_START, test_start))
    periods.add((f"{test_year - ROLLING_YEARS}-01-01", test_start))
    periods.add((test_start, test_end))

period_results = {}
for fast_window in FAST_WINDOWS:
    for slow_window in SLOW_WINDOWS:
        factors, positions, entry_factors = build_strategy_matrices(prepared, fast_window, slow_window, calendar)
        for start, end in periods:
            summary, _ = evaluate_period(factors, positions, entry_factors, start, end)
            period_results[(start, end, fast_window, slow_window)] = summary

step_rows = []
equity_segments = {"확장형": [], "롤링형": [], "고정 EMA 20·100": []}
for method in ("확장형", "롤링형"):
    for test_year in TEST_YEARS:
        train_start = INITIAL_TRAIN_START if method == "확장형" else f"{test_year - ROLLING_YEARS}-01-01"
        train_end = f"{test_year}-01-01"
        test_start = train_end
        test_end = f"{test_year + 1}-01-01"
        grid_rows = []
        for fast_window in FAST_WINDOWS:
            for slow_window in SLOW_WINDOWS:
                train = period_results[(train_start, train_end, fast_window, slow_window)]
                grid_rows.append({"fast_window": fast_window, "slow_window": slow_window, **{f"train_{key}": value for key, value in train.items()}})
        grid_frame = pd.DataFrame(grid_rows)
        fast_window, slow_window, neighbor_median_cagr, neighbor_std_cagr, plateau_score = select_plateau(grid_frame)
        train = period_results[(train_start, train_end, fast_window, slow_window)]
        test = period_results[(test_start, test_end, fast_window, slow_window)]
        factors, positions, entry_factors = build_strategy_matrices(prepared, fast_window, slow_window, calendar)
        _, test_equity = evaluate_period(factors, positions, entry_factors, test_start, test_end, include_equity=True)
        equity_segments[method].append(test_equity)
        step_rows.append({"method": method, "test_year": test_year, "train_start": train_start, "train_end": train_end, "fast_window": fast_window, "slow_window": slow_window, "neighbor_median_cagr": neighbor_median_cagr, "neighbor_std_cagr": neighbor_std_cagr, "plateau_score": plateau_score, **{f"train_{key}": value for key, value in train.items()}, **{f"test_{key}": value for key, value in test.items()}})

fixed_factors, fixed_positions, fixed_entry_factors = build_strategy_matrices(prepared, 20, 100, calendar)
fixed_rows = []
for test_year in TEST_YEARS:
    test_start = f"{test_year}-01-01"
    test_end = f"{test_year + 1}-01-01"
    fixed_summary, fixed_equity = evaluate_period(fixed_factors, fixed_positions, fixed_entry_factors, test_start, test_end, include_equity=True)
    equity_segments["고정 EMA 20·100"].append(fixed_equity)
    fixed_rows.append({"test_year": test_year, **fixed_summary})

steps = pd.DataFrame(step_rows)
equities = {method: chain_segments(segments) for method, segments in equity_segments.items()}
summary_rows = [summarize_method(method, steps.loc[steps["method"] == method], equities[method]) for method in ("확장형", "롤링형")]
fixed_steps = pd.DataFrame(fixed_rows).rename(columns={"return": "test_return", "trade_count": "test_trade_count", "exposure": "test_exposure"})
fixed_equity = equities["고정 EMA 20·100"]
elapsed_years = (fixed_equity.index[-1] - fixed_equity.index[0]).days / 365.25
summary_rows.append({"method": "고정 EMA 20·100", "return": float(fixed_equity["equity"].iloc[-1] - 1.0), "cagr": float(fixed_equity["equity"].iloc[-1] ** (1.0 / elapsed_years) - 1.0), "mdd": float(fixed_equity["drawdown"].min()), "positive_years": int((fixed_steps["test_return"] > 0.0).sum()), "parameter_changes": 0, "unique_parameters": 1, "median_forward_efficiency": np.nan, "average_trades": float(fixed_steps["test_trade_count"].mean()), "average_exposure": float(fixed_steps["test_exposure"].mean())})
summary = pd.DataFrame(summary_rows)
steps.to_csv(STEP_FILE, index=False, encoding="utf-8-sig")
summary.to_csv(SUMMARY_FILE, index=False, encoding="utf-8-sig")
draw_chart(steps, equities, summary)

print(summary.to_string(index=False, formatters={"return": "{:+.2%}".format, "cagr": "{:+.2%}".format, "mdd": "{:.2%}".format, "median_forward_efficiency": lambda value: "-" if pd.isna(value) else f"{value:.1%}", "average_trades": "{:.1f}".format, "average_exposure": "{:.1%}".format}))
print("\n선택 변수")
print(steps.pivot(index="test_year", columns="method", values=["fast_window", "slow_window", "test_return"]).to_string())
print(f"단계 결과 저장: {STEP_FILE}")
print(f"요약 저장: {SUMMARY_FILE}")
print(f"차트 저장: {CHART_FILE}")
period_results에는 각 과거 구간과 변수 조합의 평가 결과를 저장합니다. 검증 연도의 값은 후보를 고르는 select_plateau()에 전달하지 않습니다. 선택이 끝난 뒤 같은 변수로 다음 한 해를 계산하고 chain_segments()가 표본외 자산만 연결합니다.
6. 누적수익률은 301%와 305%로 거의 같았다
작성 환경에서 실행한 결과입니다.
| 방법 | 누적수익률 | CAGR | MDD | 수익 연도 | 평균 거래 수 | 평균 노출 |
|---|---|---|---|---|---|---|
| 확장형 | +301.42% | +18.99% | -22.92% | 7/8 | 53.2회 | 54.16% |
| 롤링형 | +305.26% | +19.14% | -23.06% | 7/8 | 57.8회 | 54.20% |
| 고정 EMA 20·100 | +287.41% | +18.47% | -22.68% | 6/8 | 66.1회 | 53.74% |
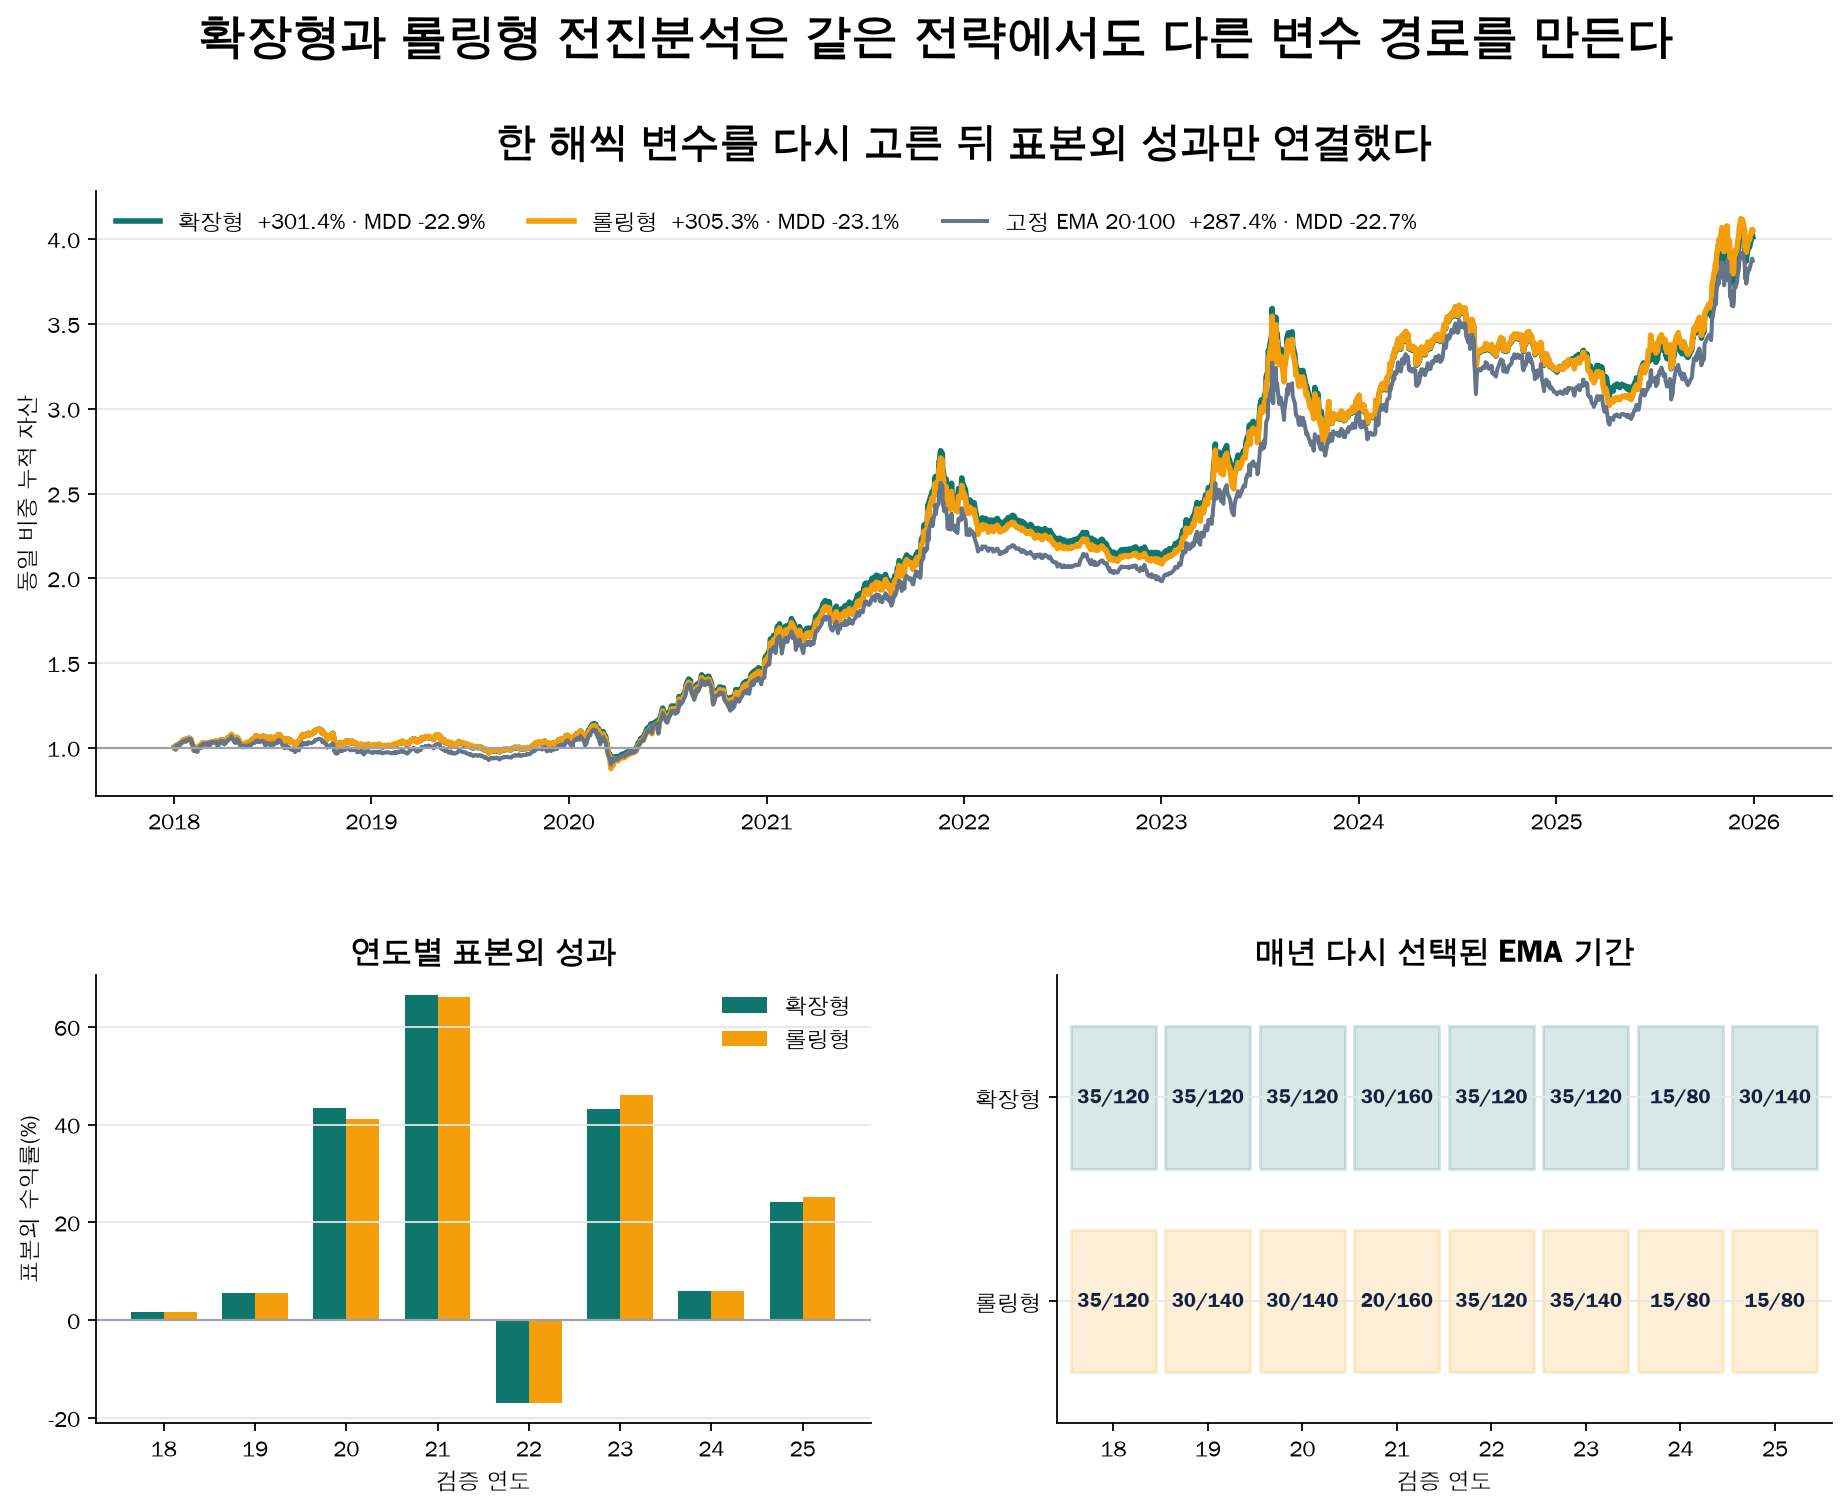
롤링형 누적수익률이 확장형보다 3.84%p 높았습니다. CAGR 차이는 0.15%p에 불과했고, MDD는 롤링형이 0.14%p 더 깊었습니다. 이 정도 결과만으로 롤링형이 우월하다고 말하기는 어렵습니다.
고정 EMA 20·100도 +287.41%를 기록했습니다. 매년 변수를 다시 고른 두 방식보다 낮았지만 MDD는 오히려 조금 작았습니다. 재최적화가 고정 규칙을 압도한 결과도 아닙니다.
변수를 바꾸는 복잡성과 검증 부담까지 생각하면 누적수익률 차이만으로 매년 재최적화를 선택하기 어렵습니다. 누적수익률과 MDD를 함께 읽는 성과표 실험처럼 성과의 높이와 경로를 함께 봐야 합니다.
7. 두 방식 모두 같은 해에 손실을 피하지 못했다
연도별 표본외 수익률은 다음과 같습니다.
| 검증 연도 | 확장형 | 롤링형 |
|---|---|---|
| 2018 | +1.66% | +1.66% |
| 2019 | +5.53% | +5.62% |
| 2020 | +43.36% | +41.12% |
| 2021 | +66.45% | +66.02% |
| 2022 | -16.87% | -16.87% |
| 2023 | +43.22% | +45.98% |
| 2024 | +5.97% | +5.97% |
| 2025 | +24.27% | +25.27% |
두 방식은 8년 중 7년 수익이었습니다. 하지만 2022년에는 똑같이 EMA 35·120을 선택했고 -16.87%를 기록했습니다. 과거 구간을 다르게 구성해도 같은 후보가 선택되면 같은 시장 변화에 함께 흔들릴 수 있습니다.
2020년과 2021년의 큰 수익이 전체 누적수익률을 끌어올렸습니다. 반면 2018년, 2019년, 2024년은 플러스였지만 한 자릿수 수익률이었습니다. 최종 +300%만 보면 연도별 성과 집중과 손실 구간이 가려집니다.
8. 성과보다 변수 경로에서 차이가 더 잘 보였다
| 검증 연도 | 확장형 EMA | 롤링형 EMA |
|---|---|---|
| 2018 | 35·120 | 35·120 |
| 2019 | 35·120 | 30·140 |
| 2020 | 35·120 | 30·140 |
| 2021 | 30·160 | 20·160 |
| 2022 | 35·120 | 35·120 |
| 2023 | 35·120 | 35·140 |
| 2024 | 15·80 | 15·80 |
| 2025 | 30·140 | 15·80 |
확장형은 8단계에서 변수를 4번 바꾸고 4개의 고유 조합을 사용했습니다. 롤링형은 5번 바꾸고 5개 조합을 사용했습니다. 오래된 데이터를 버리는 롤링형이 최근 구간의 변화에 더 자주 반응했습니다.
그런데 서로 다른 조합을 고른 연도에도 표본외 수익률 차이는 대부분 작았습니다. 예를 들어 2021년 확장형은 EMA 30·160, 롤링형은 20·160을 골랐지만 수익률은 +66.45%와 +66.02%였습니다.
이는 인접한 EMA 조합들이 비슷한 추세를 포착했기 때문입니다. 변수가 달라졌다는 사실만으로 전략의 행동이 완전히 달라졌다고 볼 수 없습니다. 변수 숫자와 함께 실제 진입일, 노출 비중과 거래 수를 확인해야 합니다.
9. 전진효율 하나로 통과 여부를 정하지 않는다
전진효율은 표본외 연간 수익률을 선택 구간의 연평균 성과로 나눈 값입니다. 과거 기대치가 다음 구간에서 얼마나 유지됐는지 보는 보조 지표입니다.
이번 실험의 단계별 전진효율 중앙값은 확장형 108.36%, 롤링형 88.74%였습니다. 하지만 2022년처럼 표본외 수익률이 음수이면 전진효율도 음수가 되고, 2020년처럼 한 해 수익이 크면 수백 퍼센트까지 올라갑니다.
연간 표본외 구간이 여덟 개뿐인 상황에서 평균이나 임계값 하나로 전략을 통과시키면 극단값의 영향을 크게 받습니다. 전진효율은 수익 연도 비율, MDD, 변수 변경 횟수와 함께 해석해야 합니다.
10. 실제 운용 방식을 정할 때 확인할 것
시장 구조가 천천히 변한다고 보는가
오래된 데이터에도 의미가 있다고 판단하면 확장형이 자연스럽습니다. 표본이 계속 늘어나 결과가 안정적이지만 최근 변화의 영향은 희석됩니다.
최근 환경을 더 중요하게 볼 근거가 있는가
전략이 변동성이나 시장 미시구조 변화에 민감하다면 롤링형을 검토할 수 있습니다. 다만 학습 구간 길이와 재선택 주기 자체가 새로운 변수가 됩니다.
재최적화가 고정 규칙보다 충분히 나았는가
이번 결과에서 재최적화 방식은 고정 EMA보다 누적수익률이 14.01~17.85%p 높았지만 MDD 개선은 없었습니다. 이 차이가 추가 검증, 변수 변경과 운영 복잡성을 감수할 정도인지 판단해야 합니다.
변수 변경 뒤 주문과 포지션은 어떻게 처리할 것인가
이번 코드는 연말에 청산하고 새해에 다시 시작했습니다. 실전에서는 기존 포지션을 유지할지, 새 규칙이 청산을 요구할 때만 바꿀지, 즉시 리밸런싱할지 미리 정해야 합니다.
11. 이번 실험의 한계
첫째, 현재 확인 가능한 30종목을 사용해 상장폐지 종목이 빠진 생존 편향이 남아 있습니다.
둘째, yfinance 수정주가 일봉과 단순화한 비용을 사용했습니다. 세금, 호가 스프레드, 시장 충격과 주문 실패를 완전히 반영하지 않았습니다.
셋째, 롤링 학습 기간을 4년, 검증 기간과 재선택 주기를 1년으로 고정했습니다. 이 길이를 바꾸면 다른 결과가 나올 수 있습니다.
넷째, 연도 전환마다 포지션을 청산했습니다. 실제 계좌에서 포지션을 이어가는 방식과 거래비용이 다를 수 있습니다.
다섯째, 2018~2025년 표본외 결과는 이 글을 작성하면서 이미 확인했습니다. 결과를 본 뒤 전략이나 선택 기준을 수정하면 더 이상 표본외 데이터가 아닙니다. 다음 수정은 새로운 미래 데이터나 별도의 종목군에서 다시 검증해야 합니다.
12. 정리
이번 전진분석에서 확인한 사실은 세 가지입니다.
- 확장형과 롤링형은 +301.42%, +305.26%로 성과와 MDD가 거의 같았습니다.
- 롤링형은 최근 4년만 사용해 변수를 더 자주 바꿨지만 더 나은 위험 조정 성과로 이어지지는 않았습니다.
- 두 방식 모두 2022년 -16.87%를 피하지 못했고, 고정 EMA와 비교한 MDD 개선도 없었습니다.
전진분석의 목적은 가장 높은 누적수익률을 만드는 방식을 고르는 데 있지 않습니다. 과거의 변수 선택 절차를 여러 시점에서 반복했을 때 성과, 위험과 변수 변화가 감당할 수 있는 범위에 머무는지 확인하는 과정입니다.
다음 글에서는 EMA 교차, 채널 돌파와 역추세 전략의 일별 수익률을 함께 놓습니다. 개별 수익률이 높은 전략을 단순히 묶는 것과 상관관계가 낮은 전략을 조합하는 것이 포트폴리오 MDD에 어떤 차이를 만드는지 확인합니다.
이 글은 과거 데이터를 이용한 백테스트 예제이며 특정 종목이나 전략의 미래 수익을 보장하지 않습니다. 실제 투자에서는 세금, 수수료, 슬리피지, 체결 가능성과 계좌 위험을 별도로 검토해야 합니다.