백테스트를 끝내면 가장 먼저 마지막 누적수익률을 보게 됩니다. 40%와 39%라면 두 전략의 차이가 거의 없다고 생각하기 쉽습니다. 하지만 최종 지점이 비슷하다고 그곳까지 가는 과정도 같은 것은 아닙니다.
같은 30종목과 같은 진입 규칙에서 청산선만 20일과 40일로 바꿔 비교했습니다. 누적수익률 차이는 1.48%p였지만 MDD는 -7.83%와 -12.34%로 벌어졌습니다. 40일선 청산이 견뎌야 했던 최대 낙폭은 20일선 청산의 약 1.6배였습니다.
이번 글에서는 누적수익률 옆에 어떤 숫자를 놓아야 이 차이를 발견할 수 있는지 한 장의 파이썬 성과표로 정리합니다.
1. 마지막 수익률은 경로를 지운 숫자다
누적수익률은 시작 자산이 마지막에 얼마나 늘었는지 알려줍니다. 하지만 그 사이에 다음 상황이 있었는지는 말해주지 않습니다.
- 고점에서 얼마나 크게 밀렸는가
- 손실 거래를 수익 거래가 충분히 덮었는가
- 한 번의 큰 수익이 전체 결과를 만들었는가
- 거래 횟수가 너무 적어 우연일 가능성이 큰가
- 자금이 시장에 얼마나 오래 노출됐는가
그래서 성과표는 수익 → 위험 → 거래 품질 → 표본과 노출 순서로 읽는 것이 좋습니다.
| 질문 | 확인할 지표 |
|---|---|
| 얼마나 벌었는가 | 누적수익률, CAGR |
| 얼마나 힘들게 벌었는가 | MDD, Calmar |
| 수익과 손실의 구조는 어떤가 | Profit Factor, 평균손익비, 승률 |
| 결과를 믿을 표본이 있는가 | 거래 수 |
| 자금이 위험에 놓인 시간은 얼마인가 | 노출 비중 |
2. 누적수익률이 비슷한 두 전략을 고정한다
아무 종목이나 돌렸더니 498번 매매, 거래대금·ATR로 거르는 법에서 사용한 30종목과 필터를 그대로 사용했습니다. 비교 대상은 다음 두 전략입니다.
| 항목 | 20일선 청산 | 40일선 청산 |
|---|---|---|
| 종목 | 같은 국내 주식 30종목 | 같음 |
| 진입 | 상승 추세·20일선 회복·거래량 증가 | 같음 |
| 종목 필터 | 20일 중앙 거래대금 100억 원 이상, ATR 1.5~6.0% | 같음 |
| 체결 | 신호 다음 거래일 시가 | 같음 |
| 비용 | 매수·매도 각각 0.05% | 같음 |
| 청산 | 종가가 20일선 하향 이탈 | 종가가 40일선 하향 이탈 |
40일선은 가격에서 더 멀리 떨어져 있어 포지션을 오래 유지하는 경향이 있습니다. 그 결과 큰 추세를 더 오래 보유할 수 있지만, 반전이 시작됐을 때 수익을 더 많이 반납할 수도 있습니다.
두 청산선은 최적의 값을 찾기 위해 고른 것이 아닙니다. 동일한 진입에서 보유 기간만 달라졌을 때 누적수익률이 비슷해도 위험 지표가 달라질 수 있음을 설명하기 위한 비교입니다.
3. 성과표의 지표를 먼저 정의하기
누적수익률과 CAGR
누적수익률은 전체 구간의 최종 성과이고 CAGR은 이를 연평균 복리 성장률로 바꾼 값입니다. 검증 기간이 다른 전략을 비교할 때는 누적수익률보다 CAGR이 유용합니다.
CAGR = (마지막 자산 ÷ 시작 자산)^(1 ÷ 경과 연수) - 1
MDD와 Calmar
MDD는 각 시점의 고점에서 가장 크게 하락한 비율입니다. Calmar는 CAGR을 MDD 절댓값으로 나눠 감수한 낙폭 대비 성장률을 봅니다.
Drawdown = 해당 시점 자산 ÷ 이전 최고 자산 - 1
Calmar = CAGR ÷ |MDD|
Calmar가 높을수록 같은 낙폭에서 더 높은 연평균 성과를 냈다는 뜻입니다. 다만 짧은 검증 구간이나 특정 상승장에서는 과대평가될 수 있습니다.
Profit Factor와 평균손익비
Profit Factor는 모든 수익 금액의 합을 모든 손실 금액의 절댓값 합으로 나눕니다.
Profit Factor = 총이익 ÷ |총손실|
평균손익비 = 평균 수익 거래 수익률 ÷ |평균 손실 거래 수익률|
Profit Factor가 1보다 크면 총이익이 총손실보다 컸다는 의미입니다. 평균손익비는 한 번 이길 때의 크기와 한 번 질 때의 크기를 비교합니다. 승률이 낮아도 손익비가 충분히 높으면 전략은 이익을 낼 수 있습니다.
거래 수와 노출 비중
거래 수가 너무 적으면 높은 Profit Factor도 몇 번의 큰 거래에 의해 만들어질 수 있습니다. 노출 비중은 전체 거래일과 종목 중 포지션을 보유한 비율입니다.
같은 CAGR이라면 노출 비중이 낮은 전략은 현금을 다른 전략에 배분할 여지가 있습니다. 반대로 노출 비중이 높으면 시장 충격과 급락에 노출되는 시간도 길어집니다.
4. 전체 Python 코드
필요한 패키지는 터미널에서 먼저 설치합니다.
python -m pip install yfinance pandas numpy matplotlib
아래 코드 하나가 두 청산 전략을 같은 조건으로 실행하고 성과표와 비교 차트를 저장합니다.
from pathlib import Path

import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import yfinance as yf
from matplotlib import font_manager


TICKERS = ["005930.KS", "000660.KS", "005380.KS", "000270.KS", "035420.KS", "035720.KS", "068270.KS", "207940.KS", "105560.KS", "055550.KS", "066570.KS", "012330.KS", "028260.KS", "017670.KS", "009150.KS", "003670.KS", "042700.KS", "000810.KS", "196170.KQ", "247540.KQ", "086520.KQ", "058470.KQ", "035900.KQ", "041510.KQ", "067160.KQ", "263750.KQ", "293490.KQ", "112040.KQ", "036930.KQ", "240810.KQ"]
START_DATE = "2018-01-01"
END_DATE = "2026-01-01"
TURNOVER_FLOOR = 10_000_000_000
ATR_MIN = 1.5
ATR_MAX = 6.0
VOLUME_MULTIPLIER = 1.2
COST_RATE = 0.0005
EXIT_WINDOWS = {"20일선 청산": 20, "40일선 청산": 40}
CHART_FILE = Path("performance_report_chart.png")
RESULT_FILE = Path("performance_report_results.csv")


def prepare_price(raw: pd.DataFrame, ticker: str) -> pd.DataFrame:
    data = raw[ticker].rename(columns=str.lower).dropna().copy()
    data["sma_20"] = data["close"].rolling(20).mean()
    data["sma_40"] = data["close"].rolling(40).mean()
    data["sma_60"] = data["close"].rolling(60).mean()
    data["sma_120"] = data["close"].rolling(120).mean()
    data["volume_average_20"] = data["volume"].shift(1).rolling(20).mean()
    data["entry_signal"] = (data["sma_60"] > data["sma_120"]) & (data["close"] > data["sma_120"]) & (data["close"] > data["sma_20"]) & (data["close"].shift(1) <= data["sma_20"].shift(1)) & (data["volume"] >= data["volume_average_20"] * VOLUME_MULTIPLIER)
    previous_close = data["close"].shift(1)
    true_range = pd.concat([data["high"] - data["low"], (data["high"] - previous_close).abs(), (data["low"] - previous_close).abs()], axis=1).max(axis=1)
    data["turnover_20"] = (data["close"] * data["volume"]).shift(1).rolling(20).median()
    data["atr_percent"] = true_range.shift(1).rolling(14).mean() / data["close"].shift(1) * 100.0
    data["eligible"] = (data["turnover_20"] >= TURNOVER_FLOOR) & data["atr_percent"].between(ATR_MIN, ATR_MAX)
    return data.dropna(subset=["sma_120", "turnover_20", "atr_percent"])


def run_backtest(data: pd.DataFrame, exit_window: int) -> tuple[pd.DataFrame, pd.DataFrame]:
    exit_average = data["close"].rolling(exit_window).mean()
    exit_signal = (data["close"] < exit_average) & (data["close"].shift(1) >= exit_average.shift(1))
    cash = 1.0
    shares = 0.0
    pending_order = None
    current_trade = None
    trades = []
    daily_records = []

    for date, row in data.iterrows():
        if pending_order is not None:
            if pending_order["side"] == "buy" and shares == 0.0:
                capital_before = cash
                entry_price = float(row["open"])
                shares = cash * (1.0 - COST_RATE) / entry_price
                cash = 0.0
                current_trade = {"entry_signal_date": pending_order["signal_date"], "entry_date": date, "entry_price": entry_price, "capital_before": capital_before}
            elif pending_order["side"] == "sell" and shares > 0.0:
                exit_price = float(row["open"])
                cash = shares * exit_price * (1.0 - COST_RATE)
                shares = 0.0
                trades.append({**current_trade, "exit_signal_date": pending_order["signal_date"], "exit_date": date, "exit_price": exit_price, "trade_return": cash / current_trade["capital_before"] - 1.0, "trade_pnl": cash - current_trade["capital_before"], "forced_exit": False})
                current_trade = None
            pending_order = None

        if shares > 0.0 and bool(exit_signal.loc[date]):
            pending_order = {"side": "sell", "signal_date": date}
        elif shares == 0.0 and bool(row["entry_signal"]) and bool(row["eligible"]):
            pending_order = {"side": "buy", "signal_date": date}

        daily_records.append({"date": date, "equity": cash + shares * float(row["close"]), "exposure": float(shares > 0.0)})

    if shares > 0.0:
        last_date = data.index[-1]
        last_close = float(data.iloc[-1]["close"])
        cash = shares * last_close * (1.0 - COST_RATE)
        trades.append({**current_trade, "exit_signal_date": last_date, "exit_date": last_date, "exit_price": last_close, "trade_return": cash / current_trade["capital_before"] - 1.0, "trade_pnl": cash - current_trade["capital_before"], "forced_exit": True})
        daily_records[-1]["equity"] = cash
        daily_records[-1]["exposure"] = 0.0

    return pd.DataFrame(trades), pd.DataFrame(daily_records).set_index("date")


def build_portfolio(price_by_ticker: dict[str, pd.DataFrame], calendar: pd.DatetimeIndex, exit_window: int) -> tuple[pd.DataFrame, pd.DataFrame]:
    equity_series = []
    exposure_series = []
    trade_frames = []
    for ticker, data in price_by_ticker.items():
        trades, daily = run_backtest(data, exit_window)
        equity_series.append(daily["equity"].reindex(calendar).ffill().fillna(1.0).rename(ticker))
        exposure_series.append(daily["exposure"].reindex(calendar).ffill().fillna(0.0).rename(ticker))
        if not trades.empty:
            trades.insert(0, "ticker", ticker)
            trade_frames.append(trades)
    portfolio = pd.DataFrame({"equity": pd.concat(equity_series, axis=1).mean(axis=1), "exposure": pd.concat(exposure_series, axis=1).mean(axis=1)})
    portfolio["drawdown"] = portfolio["equity"] / portfolio["equity"].cummax() - 1.0
    return pd.concat(trade_frames, ignore_index=True), portfolio


def summarize(trades: pd.DataFrame, portfolio: pd.DataFrame) -> dict[str, float]:
    elapsed_years = (portfolio.index[-1] - portfolio.index[0]).days / 365.25
    total_return = float(portfolio["equity"].iloc[-1] - 1.0)
    cagr = float(portfolio["equity"].iloc[-1] ** (1.0 / elapsed_years) - 1.0)
    mdd = float(portfolio["drawdown"].min())
    profit_amounts = trades.loc[trades["trade_pnl"] > 0.0, "trade_pnl"]
    loss_amounts = trades.loc[trades["trade_pnl"] < 0.0, "trade_pnl"]
    winning_returns = trades.loc[trades["trade_return"] > 0.0, "trade_return"]
    losing_returns = trades.loc[trades["trade_return"] < 0.0, "trade_return"]
    profit_factor = float(profit_amounts.sum() / loss_amounts.abs().sum())
    payoff_ratio = float(winning_returns.mean() / losing_returns.abs().mean())
    return {"누적수익률": total_return, "CAGR": cagr, "MDD": mdd, "Calmar": cagr / abs(mdd), "Profit Factor": profit_factor, "평균손익비": payoff_ratio, "승률": float((trades["trade_return"] > 0.0).mean()), "거래수": float(len(trades)), "노출비중": float(portfolio["exposure"].mean())}


available_fonts = {item.name for item in font_manager.fontManager.ttflist}
for font_name in ("Malgun Gothic", "AppleGothic", "UnDotum", "DejaVu Sans"):
    if font_name in available_fonts:
        plt.rcParams["font.family"] = font_name
        break
plt.rcParams["axes.unicode_minus"] = False

raw = yf.download(TICKERS, start=START_DATE, end=END_DATE, auto_adjust=True, progress=False, group_by="ticker", threads=False)
if raw.empty:
    raise RuntimeError("가격 데이터를 받지 못했습니다.")

price_by_ticker = {ticker: prepare_price(raw, ticker) for ticker in TICKERS}
trade_results = {}
portfolio_results = {}
summary_rows = {}
for label, exit_window in EXIT_WINDOWS.items():
    trades, portfolio = build_portfolio(price_by_ticker, raw.index, exit_window)
    trade_results[label] = trades
    portfolio_results[label] = portfolio
    summary_rows[label] = summarize(trades, portfolio)

summary = pd.DataFrame(summary_rows).T
summary["거래수"] = summary["거래수"].astype(int)
summary.to_csv(RESULT_FILE, encoding="utf-8-sig")
print(summary.to_string(formatters={"누적수익률": "{:.2%}".format, "CAGR": "{:.2%}".format, "MDD": "{:.2%}".format, "Calmar": "{:.2f}".format, "Profit Factor": "{:.2f}".format, "평균손익비": "{:.2f}".format, "승률": "{:.2%}".format, "노출비중": "{:.2%}".format}))

colors = {"20일선 청산": "#0F766E", "40일선 청산": "#F59E0B"}
fig = plt.figure(figsize=(13, 9), facecolor="white")
grid = fig.add_gridspec(2, 2, height_ratios=[2.2, 1.5], hspace=0.35, wspace=0.18)
equity_axis = fig.add_subplot(grid[0, :])
drawdown_axis = fig.add_subplot(grid[1, 0])
table_axis = fig.add_subplot(grid[1, 1])

for label, portfolio in portfolio_results.items():
    equity_axis.plot(portfolio.index, portfolio["equity"], color=colors[label], linewidth=2.2, label=f"{label} {summary.loc[label, '누적수익률']:.1%}")
    drawdown_axis.fill_between(portfolio.index, portfolio["drawdown"] * 100.0, 0.0, color=colors[label], alpha=0.18)
    drawdown_axis.plot(portfolio.index, portfolio["drawdown"] * 100.0, color=colors[label], linewidth=1.5, label=f"{label} {summary.loc[label, 'MDD']:.1%}")

equity_axis.set_title("누적수익률은 비슷해도 위험의 경로는 다르다", fontsize=18, fontweight="bold", pad=16)
equity_axis.set_ylabel("30종목 동일 비중 누적 자산")
equity_axis.legend(loc="upper left", frameon=False)
drawdown_axis.set_title("고점 대비 낙폭", fontsize=14, fontweight="bold")
drawdown_axis.set_ylabel("Drawdown(%)")
drawdown_axis.legend(loc="lower left", frameon=False, fontsize=9)

table_axis.axis("off")
table_data = [[f"{summary.loc[label, 'CAGR']:.2%}", f"{summary.loc[label, 'MDD']:.2%}", f"{summary.loc[label, 'Profit Factor']:.2f}", f"{summary.loc[label, '평균손익비']:.2f}", f"{summary.loc[label, '거래수']:.0f}", f"{summary.loc[label, '노출비중']:.2%}"] for label in EXIT_WINDOWS]
performance_table = table_axis.table(cellText=table_data, rowLabels=list(EXIT_WINDOWS), colLabels=["CAGR", "MDD", "PF", "손익비", "거래", "노출"], loc="center", cellLoc="center", rowLoc="center", colWidths=[0.14, 0.15, 0.11, 0.13, 0.12, 0.14])
performance_table.auto_set_font_size(False)
performance_table.set_fontsize(9)
performance_table.scale(1.0, 2.0)
for (row, column), cell in performance_table.get_celld().items():
    cell.set_edgecolor("#D1D5DB")
    if row == 0:
        cell.set_facecolor("#17233F")
        cell.get_text().set_color("white")
    elif column == -1:
        cell.set_facecolor("#F4F1E8")
table_axis.set_title("한 장의 성과표", fontsize=14, fontweight="bold", pad=14)

for axis in (equity_axis, drawdown_axis):
    axis.grid(axis="y", color="#E5E7EB", linewidth=0.8)
    axis.spines["top"].set_visible(False)
    axis.spines["left"].set_visible(False)
    axis.spines["right"].set_color("#D1D5DB")
    axis.spines["bottom"].set_color("#D1D5DB")
    axis.yaxis.tick_right()
    axis.yaxis.set_label_position("right")

fig.savefig(CHART_FILE, dpi=160, bbox_inches="tight", facecolor="white")
plt.show()
trade_pnl은 각 거래의 실제 자산 증감액을 기록합니다. Profit Factor는 이 금액의 총이익과 총손실로 계산합니다. 평균손익비는 종목과 시점 사이의 크기 차이를 줄이기 위해 거래 수익률의 평균을 사용합니다.
노출 비중은 종목별 보유 상태를 0과 1로 기록한 뒤 30종목과 전체 거래일에 대해 평균합니다. 예를 들어 10%라면 평균적으로 30종목 중 3종목에 자금이 노출된 상태와 같습니다.
5. 마지막 수익률은 1.48%p 차이였다
작성 환경에서 실행한 결과입니다.
| 지표 | 20일선 청산 | 40일선 청산 |
|---|---|---|
| 누적수익률 | 40.73% | 39.25% |
| CAGR | 4.37% | 4.23% |
| MDD | -7.83% | -12.34% |
| Calmar | 0.56 | 0.34 |
| Profit Factor | 2.30 | 2.26 |
| 평균손익비 | 4.98 | 4.82 |
| 승률 | 32.55% | 32.66% |
| 거래 수 | 384회 | 346회 |
| 노출 비중 | 7.05% | 10.99% |
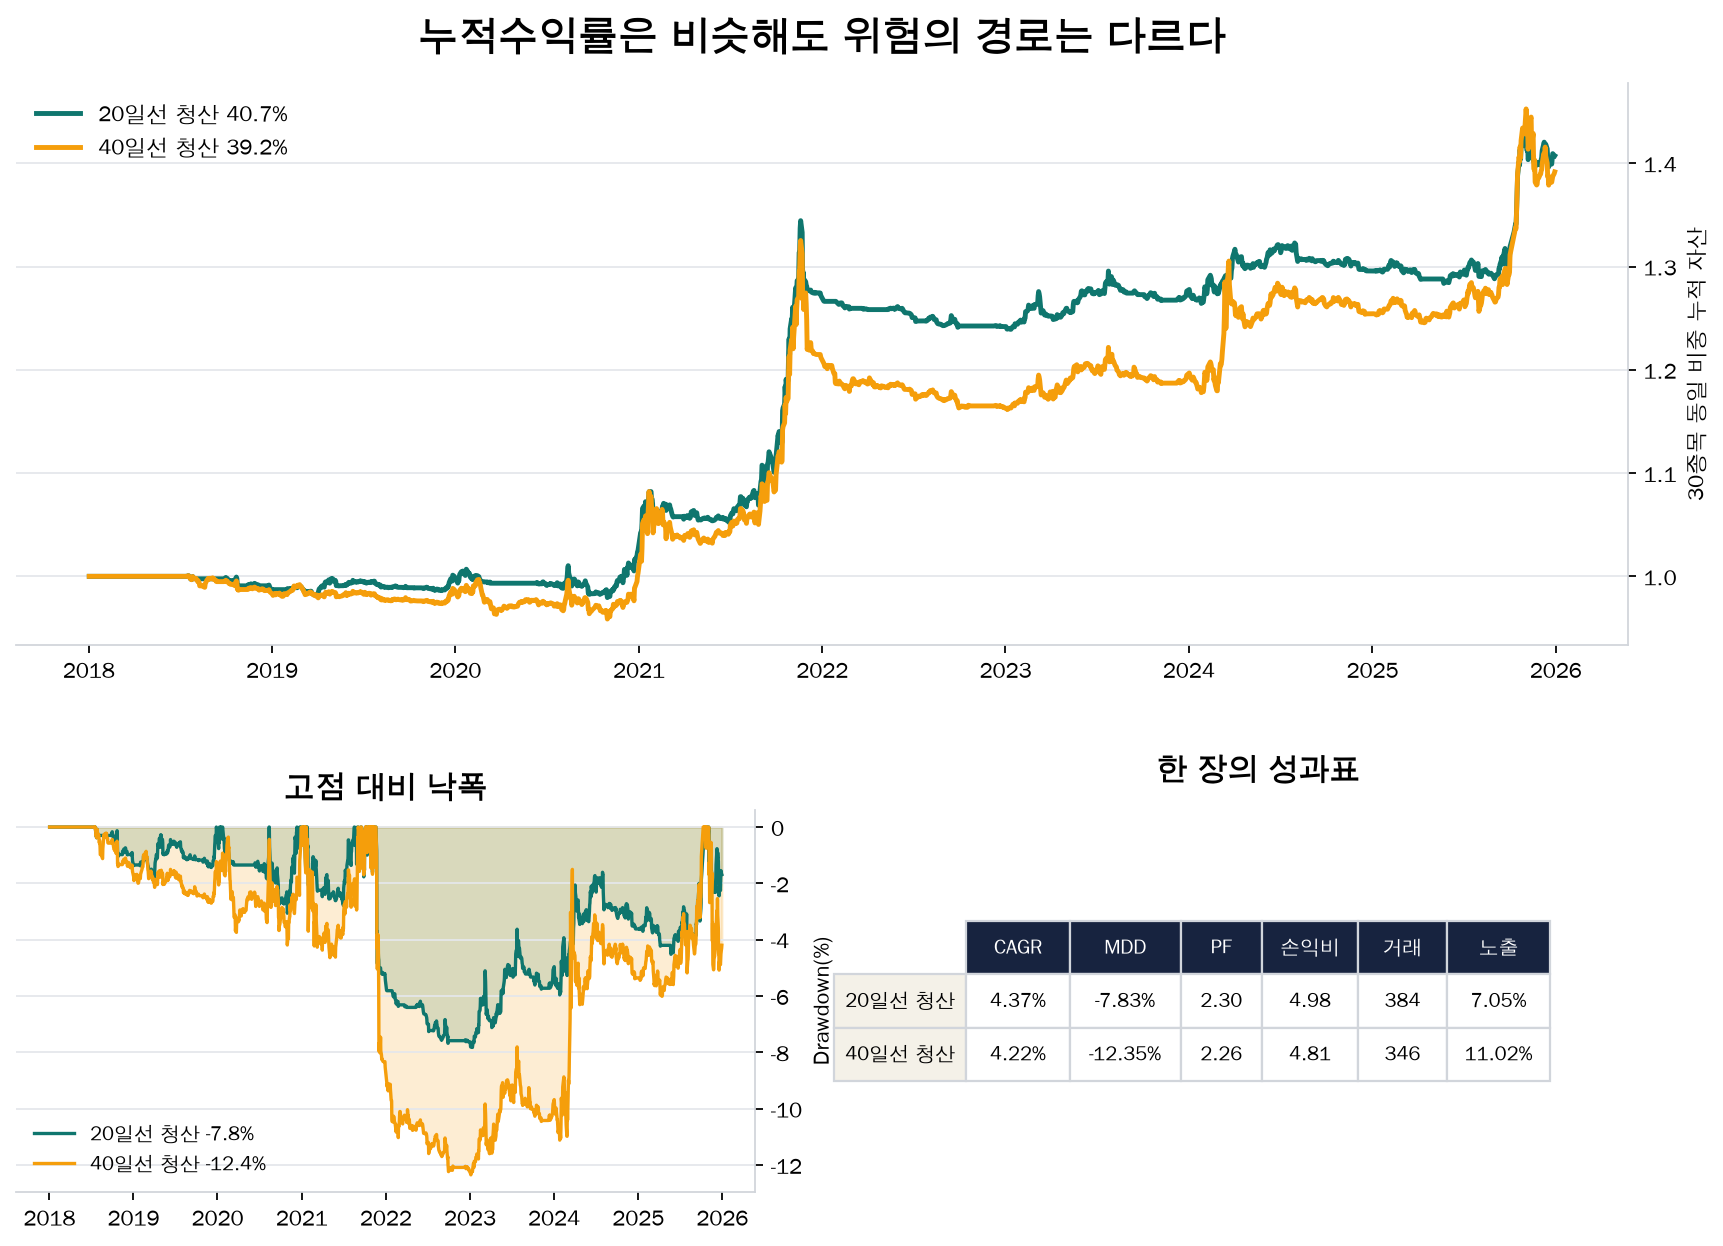
누적수익률은 40.73%와 39.25%로 비슷하고 CAGR 차이도 0.14%p입니다. 승률과 Profit Factor, 평균손익비 역시 큰 차이가 없습니다. 마지막 숫자와 거래 품질만 보면 두 전략이 거의 같아 보입니다.
하지만 MDD는 -7.83%와 -12.34%입니다. 40일선 청산의 최대 낙폭은 20일선 청산보다 4.51%p 깊고, 낙폭의 크기로는 약 1.6배입니다. Calmar도 0.56과 0.34로 벌어졌습니다.
같은 연평균 수익을 얻기 위해 40일선 청산이 더 큰 고점 대비 손실을 견뎌야 했다는 뜻입니다.
6. 노출 비중이 위험 차이를 설명한다
20일선 청산의 노출 비중은 7.05%, 40일선 청산은 10.99%였습니다. 40일선 청산이 시장에 머문 시간은 약 1.56배입니다.
청산선이 느려지면 작은 흔들림에 포지션을 닫지 않아 거래 수는 384회에서 346회로 줄어듭니다. 대신 보유 기간이 길어지고 하락 전환 이후에도 포지션이 남아 있을 가능성이 커집니다. 차트의 낙폭 구간에서 주황색 40일선 전략이 더 깊게 내려간 이유입니다.
이 비교에서 거래 수가 적다는 사실만으로 40일선이 효율적이라고 말할 수 없습니다. 거래비용은 줄어도 시장 노출과 낙폭이 커질 수 있기 때문입니다. 거래 수와 노출 비중을 함께 봐야 합니다.
7. 승률 32%인데도 Profit Factor가 2를 넘은 이유
두 전략의 승률은 약 32%입니다. 열 번 거래하면 대략 세 번만 수익 거래였다는 뜻입니다. 승률만 보면 좋지 않아 보이지만 평균손익비는 4.8 이상입니다.
손실 거래는 자주 발생했지만 한 번의 평균 수익이 평균 손실보다 훨씬 컸습니다. 추세 전략에서 흔히 나타나는 구조입니다. 작은 손실을 여러 번 감수하고 소수의 큰 추세에서 수익을 얻습니다.
따라서 승률을 높이기 위해 청산 규칙을 계속 바꾸면 큰 수익 거래를 일찍 끊어 Profit Factor가 낮아질 수 있습니다. 성과표에서는 승률, 평균손익비와 Profit Factor를 한 묶음으로 읽어야 합니다.
8. 어떤 전략을 선택해야 하는가
이번 표만 보면 20일선 청산이 더 높은 누적수익률과 낮은 MDD, 높은 Calmar를 기록했습니다. 그렇다고 20일이 앞으로도 더 좋은 청산선이라는 뜻은 아닙니다.
- 두 청산 규칙 모두 같은 고정 종목군과 한 검증 구간을 사용했습니다.
- 20일과 40일은 설명을 위해 비교한 값이며 전체 변수 범위의 안정성을 검사하지 않았습니다.
- 거래비용과 시가 체결은 단순화된 가정입니다.
- 상장폐지 종목이 없어 생존 편향이 남아 있습니다.
- yfinance 데이터 정정에 따라 세부 수치는 달라질 수 있습니다.
전략 선택은 최고 수익률 하나가 아니라 다음 질문으로 이어져야 합니다.
- 인접한 청산 기간에서도 결과가 유지되는가
- 다른 종목군과 다른 시장 구간에서도 MDD가 통제되는가
- 거래 수가 충분하고 소수 거래에 수익이 집중되지 않았는가
- 계좌가 감당할 수 있는 낙폭과 노출 수준인가
9. 마치며: 한 장의 성과표로 전략의 성격을 읽는다
이번 비교에서 확인한 결론은 세 가지입니다.
- 누적수익률 차이가 1.48%p에 불과해도 MDD는 약 1.6배 차이 날 수 있습니다.
- CAGR과 MDD를 함께 보는 Calmar가 위험 대비 성과 차이를 더 분명하게 보여줍니다.
- Profit Factor·손익비·거래 수·노출 비중을 함께 봐야 전략의 수익 구조와 운용 부담을 알 수 있습니다.
백테스트의 마지막 수익률은 전략의 성적표가 아니라 성과표의 첫 번째 칸입니다. 실제로 선택할 전략을 판단하려면 그 수익을 얻는 동안 얼마나 잃었고, 얼마나 오래 시장에 머물렀는지까지 확인해야 합니다.
다음 글부터는 기본 전략을 Python으로 다시 검증합니다. 첫 주제는 단순한 이동평균 교차가 한 종목의 좋은 구간을 벗어나 여러 종목과 구간에서도 살아남는지 확인하는 실험입니다.
이 글의 백테스트는 성과지표의 해석을 설명하기 위한 교육용 예시입니다. 과거 성과는 미래 수익을 보장하지 않으며 실제 투자 판단과 책임은 투자자 본인에게 있습니다.